سلسلة الذكاء الاصطناعي للمبتدئين / المقال (9 من 30)
مرحبًا بكم أعزائي القراء في سلسلة “الذكاء الاصطناعي للمبتدئين” التي تقدمها مدونة النائب للعلوم والتكنولوجيا. تهدف هذه السلسلة إلى شرح مفاهيم الذكاء الاصطناعي وأدواته وتطبيقاته بلغة عربية مبسطة، لتكون مرجعًا للقارئ العربي في هذا المجال المتطور.
عزيزي القارئ لنبدأ من تجربة تعرفها: قد تسأل ChatGPT سؤالًا، فتحصل خلال ثوانٍ على إجابة مكتوبة بلغة سليمة، ومنظمة بطريقة مقنعة، ومليئة بالتفاصيل. وقد يذكر لك اسم كتاب، أو تاريخًا، أو دراسة علمية، أو حتى مرجعًا يبدو حقيقيًا تمامًا.
لكن عندما تبحث عن ذلك المرجع… قد تكتشف أنه غير موجود أصلًا!
والأغرب من ذلك أن الذكاء الاصطناعي لم يقل: «لست متأكدًا»، بل قدّم المعلومة الخاطئة بثقة كبيرة.
فلماذا يحدث ذلك؟
هل يكذب ChatGPT؟ هل يفهم السؤال بصورة خاطئة؟ أم أن هناك مشكلة في طريقة عمل الذكاء الاصطناعي نفسه؟
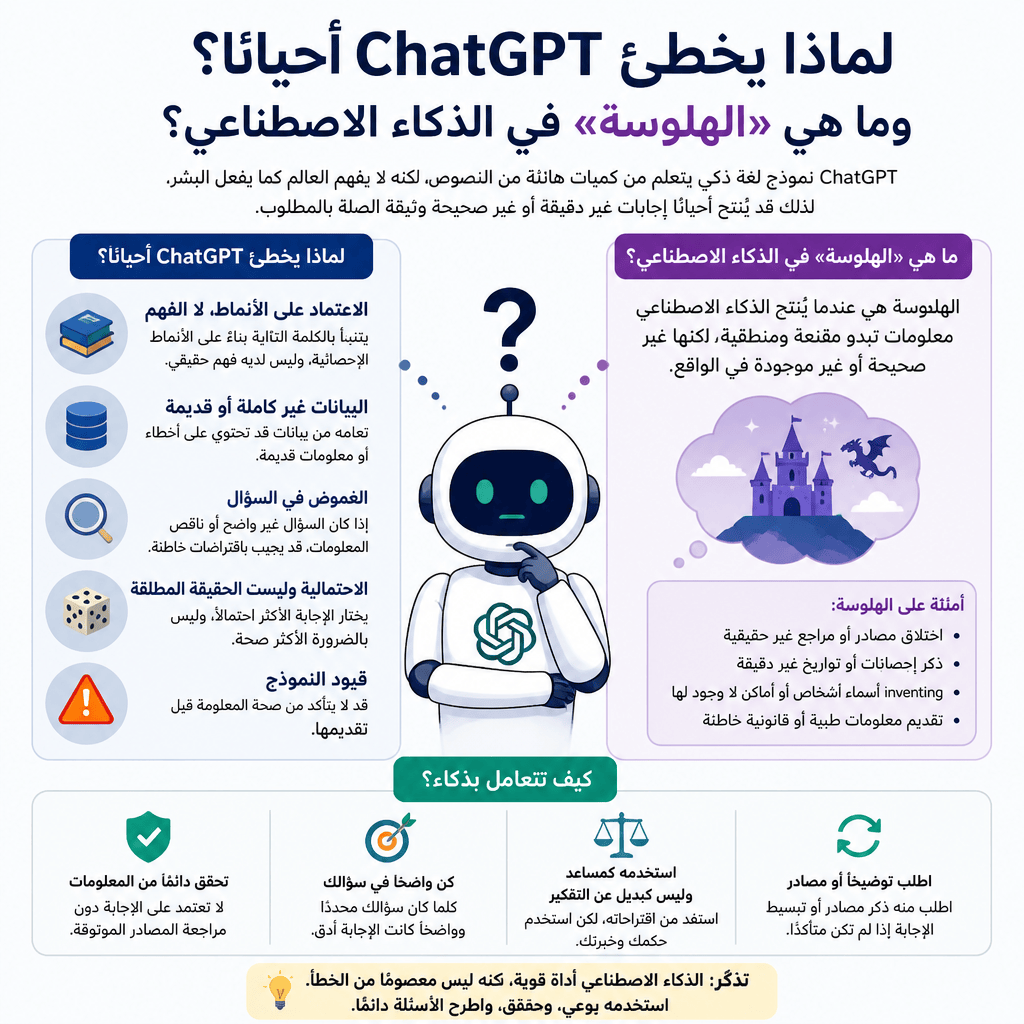
لفهم ذلك، علينا التعرف إلى واحدة من أشهر المشكلات في عالم الذكاء الاصطناعي التوليدي، وهي ما يُطلق عليه: الهلوسة في الذكاء الاصطناعي – AI Hallucination.
وسنكتشف في هذا المقال لماذا تحدث الهلوسة، وما الأشكال التي قد تأخذها، ولماذا يمكن أن تبدو المعلومة الخاطئة مقنعة جدًا، والأهم: كيف ينبغي لنا كمستخدمين أن نتعامل معها.
أولًا: ما المقصود بهلوسة الذكاء الاصطناعي؟
مصطلح «الهلوسة» (AI Hallucination) قد يبدو غريبًا بعض الشيء، وهو بالتأكيد لا يعني أن الذكاء الاصطناعي «يهلوس» بالطريقة التي يفعلها الإنسان.
المقصود بالهلوسة، بصورة مبسطة، هو أن يُنتج نموذج الذكاء الاصطناعي معلومات خاطئة أو غير مدعومة بمصادر موثوقة، لكنه يقدمها بطريقة تبدو معقولة ومقنعة وكأنها صحيحة.
وقد تكون الهلوسة بسيطة، مثل ذكر تاريخ أو رقم غير صحيح، وقد تكون أكثر وضوحًا، مثل اختراع اسم كتاب أو دراسة علمية أو مرجع غير موجود أصلًا، أو نسبة تصريح إلى شخص لم يقله.
وهنا تكمن المشكلة الحقيقية: فالذكاء الاصطناعي لا يضع بالضرورة إشارة تحذير أمام المعلومة الخاطئة، بل قد يقدمها باللغة نفسها والأسلوب الواثق نفسه الذي يقدم به معلومة صحيحة.
لذلك فإن سهولة قراءة الإجابة وجودة صياغتها لا تعنيان بالضرورة أن المعلومات الواردة فيها صحيحة.
ثانياً: ولكن لماذا تحدث الهلوسة أصلًا؟
لفهم ذلك، علينا أن نتذكر فكرة بسيطة تحدثنا عنها في المقال السابق عن النماذج اللغوية الكبيرة (LLMs).
عندما تسأل ChatGPT سؤالًا، فهو لا يعمل كموسوعة تحتوي على قائمة جاهزة من الحقائق، كما قد نتخيل. بل يعتمد على الأنماط والعلاقات التي تعلمها من كميات هائلة من النصوص أثناء التدريب، ويستخدمها لتكوين الإجابة.
وبصورة مبسطة، يبني النموذج إجابته خطوة بعد خطوة، من خلال توقع الرمز النصي التالي (Token) الأكثر ملاءمة للسياق.
خذ هذا المثال البسيط:
«عاصمة فرنسا هي…»
من السهل على النموذج إكمال الجملة بـ «باريس»، لأن هذه العلاقة واضحة جدًا وتكررت كثيرًا في البيانات التي تعلم منها.
لكن ماذا لو سألناه عن معلومة نادرة جدًا، أو معلومة دقيقة أو نادرة، أو تاريخ دقيق لا يملك عنه معلومات كافية؟
هنا قد تحدث المشكلة.
فبدلًا من التوقف دائمًا والقول: «لا أعرف»، قد يولّد النموذج إجابة تبدو مناسبة لما سألناه عنه، لكنها ليست صحيحة.
قد يخترع اسمًا، أو يخطئ في تاريخ، أو يذكر رقمًا غير صحيح، أو حتى يقدم مرجعًا يبدو حقيقيًا لكنه غير موجود.
وهذا هو جوهر المشكلة: ChatGPT بارع جدًا في تكوين إجابات تبدو طبيعية ومقنعة، لكن ذلك لا يعني أن كل معلومة يذكرها صحيحة.
بعبارة أبسط:
أن تبدو الإجابة صحيحة لا يعني بالضرورة أنها صحيحة بالفعل.
ثالثاً: مثال بسيط: عندما يبدو المرجع حقيقيًا… لكنه ليس كذلك
لنفترض أننا سألنا نموذجًا للذكاء الاصطناعي:
«من اخترع أول خلية شمسية عملية من السيليكون، ومتى حدث ذلك؟»
وقدّم النموذج الإجابة الافتراضية التالية:
«اخترع الفيزيائي الأمريكي روبرت هاريس أول خلية شمسية عملية من السيليكون عام 1948 في مختبرات بيل، وبلغت كفاءتها نحو 6%.»
للوهلة الأولى، تبدو الإجابة مقنعة. فهي تحتوي على اسم عالم، وتاريخ محدد، واسم مؤسسة علمية شهيرة، بل ونسبة كفاءة أيضًا.
لكن المشكلة أن الإجابة خلطت بين بعض التفاصيل التي تبدو معقولة وتفاصيل أخرى مختلقة أو خاطئة.
فما الحقيقة؟
وفقًا للجمعية الفيزيائية الأمريكية (APS)، طوّر الباحثون Daryl Chapin وCalvin Fuller وGerald Pearson في مختبرات Bell أول خلية شمسية عملية من السيليكون، وأُعلن عنها عام 1954، وكانت كفاءتها في تحويل ضوء الشمس إلى كهرباء نحو 6%.
وهكذا نلاحظ شيئًا مثيرًا للاهتمام: الرقم 6% واسم مختبرات Bell في الإجابة الافتراضية كانا قريبين من الحقيقة، بينما كان اسم «روبرت هاريس» وسنة 1948 غير صحيحين.
وهنا تكمن المشكلة: وجود بعض المعلومات الصحيحة في الإجابة لا يعني أن بقية المعلومات صحيحة أيضًا..
رابعاً: هل ChatGPT «يعرف» أنه يقدم معلومة خاطئة؟
هذه نقطة مهمة جدًا. لا ينبغي أن نتعامل مع النموذج اللغوي كما نتعامل مع إنسان يعرف حقيقة ما ثم يقرر الكذب بشأنها.
فعندما يهلوس النموذج، لا يعني ذلك أنه يعرف الإجابة الصحيحة ثم يتعمد إخفاءها أو استبدالها بإجابة خاطئة. لذلك، فإن وصف الهلوسة بأنها «كذب» ليس دقيقًا.
الأقرب إلى ما يحدث هو أن النموذج يولّد إجابة اعتمادًا على الأنماط التي تعلمها والسياق الذي أمامه، وقد تكون هذه الإجابة غير صحيحة. وفي بعض الحالات، قد يقدمها بدلًا من أن يوضح أنه غير متأكد أو أنه لا يملك معلومات كافية.
وهنا يظهر سؤال آخر قد يحير الكثير من المستخدمين: لماذا يبدو ChatGPT واثقًا حتى عندما يكون مخطئًا؟
لأن الأسلوب الواثق وجودة الصياغة لا يشكلان دليلًا على صحة المعلومة.
فقد يكتب النموذج، مثلًا: «وفقًا لدراسة أجرتها جامعة كذا عام 2024…»
وقد تكون الجملة مكتوبة بأسلوب أكاديمي ممتاز، ومليئة بالتفاصيل، لكنها لا تصبح صحيحة لمجرد أنها تبدو صحيحة.
وهنا علينا أن نتذكر الفرق بين أمرين:الطلاقة اللغوية شيء، ودقة المعلومات شيء آخر.
فقد يكون الذكاء الاصطناعي بارعًا جدًا في طريقة صياغة الإجابة، لكنه قد يخطئ في المعلومات التي تتضمنها تلك الإجابة.
خامساً: ما الأسباب التي قد تزيد احتمال الهلوسة؟
ليست الهلوسة ناتجة عن سبب واحد، بل يمكن أن تزيد احتمالاتها في ظروف مختلفة. ومن أهمها:
- نقص المعلومات أو ندرتها: كلما كانت المعلومة نادرة أو شديدة التخصص، ازدادت احتمالية أن يخطئ النموذج فيها، خصوصًا إذا لم تكن ممثلة بصورة كافية في البيانات التي تعلم منها.
فالسؤال عن حقيقة معروفة، مثل عاصمة دولة، يختلف عن السؤال عن رقم دقيق ورد في دراسة قديمة أو وثيقة قليلة التداول.
- السؤال يحتوي على افتراض خاطئ: قد تدفع طريقة صياغة السؤال النموذج إلى السير وراء افتراض غير صحيح.
فإذا سألنا مثلًا: «ما اسم الكتاب الذي أصدره فلان عام 2025 حول الموضوع X؟»
فنحن نفترض مسبقًا أن هذا الشخص أصدر كتابًا بالفعل. وإذا كان هذا الافتراض خاطئًا، فقد يولّد النموذج في بعض الحالات عنوانًا يبدو منطقيًا بدلًا من تصحيح الافتراض. لذلك، فإن طريقة صياغة السؤال (Prompt) قد تؤثر في جودة الإجابة.
- السؤال يتعلق بمعلومات حديثة أو غير متاحة: قد نسأل النموذج عن حدث وقع مؤخرًا، أو عن معلومات لم تكن متاحة له، أو عن تفاصيل تحتاج إلى الرجوع إلى مصدر خارجي.
وفي مثل هذه الحالات، فإن الوصول إلى الإنترنت أو إلى مصادر موثوقة وحديثة يمكن أن يساعد في تقليل الأخطاء، لكنه لا يلغي احتمال حدوثها تمامًا.
- التخمين بدل قول «لا أعرف» :من المشكلات التي يعمل الباحثون على معالجتها أن النموذج قد يقدم أحيانًا إجابة محتملة بدلًا من الاعتراف بأنه غير متأكد.
وقد أشارت أبحاث OpenAI إلى أن بعض طرق تقييم النماذج يمكن أن تشجع التخمين؛ لأن الإجابة الصحيحة تحصل على مكافأة، بينما قد لا يكون الاعتراف بعدم اليقين مجزيًا بالطريقة نفسها.
لذلك يعمل الباحثون على تحسين قدرة النماذج على التعبير عن عدم اليقين بدلًا من تقديم إجابة واثقة عندما لا تتوافر معلومات كافية.
وباختصار، تزداد احتمالات الهلوسة عندما تكون المعلومات قليلة أو نادرة، أو يحتوي السؤال على افتراض خاطئ، أو تكون المعلومات حديثة وغير متاحة، أو يحاول النموذج تقديم إجابة رغم عدم كفاية المعلومات.
سادساً: ما الأشكال التي يمكن أن تأخذها الهلوسة؟
الهلوسة ليست نوعًا واحدًا من الأخطاء، بل يمكن أن تظهر بأشكال مختلفة، من أبرزها:
- اختراع المصادر والمراجع: قد يذكر النموذج اسم كتاب أو بحث أو دراسة تبدو حقيقية، لكنها غير موجودة أصلًا.
- اختراع الاقتباسات: قد ينسب عبارة إلى عالم أو كاتب أو شخصية معروفة، رغم أن هذا الشخص لم يقلها.
- الأرقام والتواريخ الخاطئة: قد يقدم إحصائية أو رقمًا أو تاريخًا يبدو معقولًا، لكنه غير صحيح.
- خلط الحقائق: قد يجمع النموذج معلومات صحيحة من مصادر أو أحداث مختلفة بطريقة تؤدي في النهاية إلى معلومة خاطئة.
- اختلاق التفاصيل: عندما لا تتوافر معلومات كافية، قد يولّد أسماء أو أحداثًا أو تفاصيل تبدو منطقية، لكنها غير حقيقية.
والأمر الذي يجعل هذه الأخطاء صعبة الاكتشاف أحيانًا هو أنها قد تظهر وسط معلومات صحيحة وداخل إجابة مكتوبة بطريقة مقنعة جدًا.
لذلك، لا يكفي أن نسأل: «هل تبدو هذه المعلومة منطقية؟» بل يجب، عند الحاجة، أن نسأل أيضًا: «هل يمكن التحقق منها؟»
سابعاً: هل كل خطأ يُعد هلوسة؟
ليس بالضرورة: قد يخطئ ChatGPT في عملية حسابية، أو يسيء فهم سؤال غامض، أو لا يلتزم بتعليمات المستخدم. هذه كلها أخطاء، لكنها لا تُصنَّف دائمًا على أنها «هلوسة».
كما أن الباحثين لا يستخدمون مصطلح الهلوسة (Hallucination) دائمًا بالتعريف نفسه؛ فقد يُستخدم أحيانًا بصورة واسعة لوصف المعلومات الخاطئة أو غير المدعومة، بينما تستخدم بعض الأبحاث مصطلحات أكثر تحديدًا لأنواع معينة من الأخطاء.
لكن بالنسبة إلينا كمستخدمين، لا نحتاج إلى الدخول في هذه التفاصيل التقنية. الأهم هو أن نتذكر:
ليست كل إجابة خاطئة هلوسة بالضرورة، لكن كل معلومة مهمة يقدمها الذكاء الاصطناعي تستحق التحقق منها قبل الاعتماد عليها.
ثامناً: هل الهلوسة مشكلة خاصة بـChatGPT؟
لا: رغم أننا نستخدم ChatGPT مثالًا في هذا المقال، فإن الهلوسة ليست مشكلة خاصة به، بل هي تحدٍّ معروف في النماذج اللغوية الكبيرة (LLMs) وأنظمة الذكاء الاصطناعي التوليدي عمومًا.
ولهذا يعمل الباحثون والشركات باستمرار على تقليل هذه الأخطاء بطرق مختلفة، مثل تحسين تدريب النماذج، وربطها بمصادر خارجية، وتطوير وسائل للتحقق من المعلومات، وتحسين قدرتها على التعبير عن عدم اليقين.
وقد ساعدت هذه التطورات على تحسين دقة النماذج، لكنها لم ولن تجعلها معصومة من الخطأ.
لذلك، تظل القاعدة المهمة:
الذكاء الاصطناعي لا ينتج دائمًا معلومات صحيحة.
تاسعاً: هل يعني ذلك أننا لا نستطيع الوثوق بالذكاء الاصطناعي؟
الأمر ليس بهذه البساطة: وجود الهلوسة لا يعني أن أدوات الذكاء الاصطناعي غير مفيدة. فهي تستطيع مساعدتنا في كثير من المهام، مثل التلخيص، والعصف الذهني، والكتابة، والبرمجة، والتعلم، وتحليل المعلومات.
لكن المشكلة تبدأ عندما نتعامل مع كل إجابة يقدمها الذكاء الاصطناعي على أنها حقيقة مؤكدة لمجرد أنها تبدو مقنعة.
لذلك، من الأفضل أن نتعامل مع الذكاء الاصطناعي بوصفه مساعدًا قويًا، وليس مصدرًا معصومًا من الخطأ.
وتزداد أهمية التحقق كلما كانت المعلومة أكثر حساسية أو كانت نتائج الخطأ فيها أكبر.
فمعلومة خاطئة عن فيلم قد تسبب إزعاجًا بسيطًا، لكن معلومة خاطئة تتعلق بالصحة أو القانون أو المال أو البحث العلمي قد تكون لها عواقب أكثر خطورة.
لذلك يمكننا الاستفادة من الذكاء الاصطناعي، ولكن مع قاعدة بسيطة:
كلما زادت أهمية المعلومة، زادت أهمية التحقق منها قبل الاعتماد عليها.
عاشراً: خمس قواعد سريعة لتقليل خطر الوقوع في الهلوسة
حتى قبل أن نتعلم كيف تتحقق من صحة إجابات الذكاء الاصطناعي؟بالتفصيل في المقال القادم، يمكننا اتباع خمس قواعد بسيطة:
- لا تعتبر الثقة في الصياغة دليلًا على صحة المعلومة.
- اطلب المصادر عندما يتعلق الأمر بمعلومة مهمة.
- افتح المصدر وتأكد أنه موجود فعلًا وأنه يقول ما نُسب إليه.
- تحقق من الأرقام والأسماء والتواريخ من مصادر موثوقة ومستقلة.
- كلما كانت المعلومة أكثر أهمية، لا تعتمد على الذكاء الاصطناعي وحده.
وهناك قاعدة سادسة ربما تكون الأهم:
لا تسأل فقط: «هل تبدو هذه الإجابة صحيحة؟» بل اسأل أيضًا: «كيف أستطيع إثبات أنها صحيحة؟»
خلاصة المقال
تعلمنا في المقال السابق كيف تعمل النماذج اللغوية الكبيرة (LLMs) بصورة مبسطة، وكيف تولّد النصوص اعتمادًا على الأنماط التي تعلمتها.
وفي هذا المقال تعرفنا إلى أحد أهم التحديات المرتبطة بهذه النماذج: الهلوسة، أي أن يقدم النموذج معلومات خاطئة أو غير دقيقة بطريقة قد تبدو مقنعة.
لذلك، عندما تستخدم ChatGPT أو أي أداة مشابهة، لا تجعل سؤالك الوحيد:
«ما الإجابة؟» بل أضف إليه سؤالًا مهمًا: «ما الدليل؟»
لكن ماذا لو أعطاك الذكاء الاصطناعي مصادر ومراجع؟ كيف تعرف أن هذه المصادر موجودة فعلًا، وأنها تدعم ما يقوله؟ وكيف تتحقق من صحة الإجابة قبل الاعتماد عليها؟
هذا ما سنتعلمه خطوة بخطوة في المقال العاشر من سلسلتنا: «كيف تتحقق من صحة إجابات الذكاء الاصطناعي؟»
مواضيع ذات صلة:
ما هو الذكاء الاصطناعي؟ شرح بسيط للمبتدئين
من الداخل: كيف يعمل ChatGPT ولماذا أصبح حديث العالم؟
ثورة المساعدات الذكية: كيف يغيّر الذكاء الاصطناعي طريقة عملنا وتعلمنا
كيف تكتب أوامر (Prompts) احترافية لبرامج الذكاء الاصطناعي؟ دليل عملي للحصول على أفضل النتائج
ما الفرق بين الذكاء الاصطناعي، والتعلم الآلي، والتعلم العميق؟
ما الفرق بين ChatGPT وGemini وClaude وCopilot؟ دليل مبسط لاختيار أفضل مساعد ذكي
كيف يتعلم الذكاء الاصطناعي من البيانات؟
ما هي النماذج اللغوية الكبيرة (LLMs)؟ شرح مبسط للمبتدئين
تعريف الإنترنت وأهميته للمستخدمين
الفرق بين الإنترنت والويب: شرح مبسط
بروتوكولات الإنترنت: ما تحتاج معرفته
أهمية بروتوكول TCP/IP في تبادل البيانات


لا توجد آراء بشأن "لماذا يخطئ ChatGPT أحيانًا؟ وما هي «الهلوسة» في الذكاء الاصطناعي؟"